Redes Neurais Artificiais para Word Embedding
por Frank de Alcantara em 19/04/2025

- 1. Você Pensa Como Fala
- 2. A Temida Matemática
- 3. A Probabilidade da Linguagem
- 4. A Vetorização Básica
- 5. Redes Neurais Artificiais para Word Embedding
- 6. Embeddings Distribuídos e CBoW
- 7. SkipGram e Otimizações do Word2Vec
- 8. Word2Vec, a Ponte para o Contexto
- 9. Desvendando a Modelagem de Sequências
- 10. Prestando Atenção
- 11. Do Código à Geração
- 12. Masked Language Modeling: Esconder Tokens para Aprender Contexto
- 13. BERT: O Encoder que Lê dos Dois Lados
- 14. O Cisma e a Batalha da Eficiência
- 15. GEMM o Coração Matemático
- 16. Do Cosseno à Borda: Busca Semântica em Produção
Transformers - Redes Neurais Artificiais: Fundamentos
“What I cannot create, I do not understand.”
— Richard Feynman
Antes de viajarmos pelos algoritmos de representação distribuída de textos e, subsequentemente, pelos Transformers, é essencial que a amável leitora seja capaz de compreender como funcionam as redes neurais artificiais (RNAs). Essa será a base técnica sobre a qual construiremos, não apenas os modelos de embeddings, que utilizam redes neurais rasas como sua estrutura fundamental, mas também arquiteturas mais complexas como os próprios Transformers, que adaptam e expandem esses conceitos. Este artigo, guiará a jovem leitora exploradora pelos mares de conceitos, arquiteturas, e matemáticas que abrigam o treinamento das RNAs. Nesta viagem, estabeleceremos os alicerces necessários para a compreensão dos modelos de embeddings e pavimentaremos, assim espero, o caminho do entendimento dos Transformers.
Inspiração Biológica e Evolução Histórica
As redes neurais artificiais foram inspiradas pelo funcionamento do cérebro humano, especificamente pelos neurônios e suas conexões sinápticas. Os primeiros modelos matemáticos de neurônios artificiais datam de 1943, quando Warren McCulloch e Walter Pitts propuseram um modelo simplificado que representava o funcionamento básico de um neurônio biológico baseado apenas nas suposições da época sobre o funcionamento dos neurônios. Esse modelo inicial, embora rudimentar, lançou as bases para o desenvolvimento de redes neurais artificiais. McCulloch e Pitts propuseram que os neurônios poderiam ser representados como unidades lógicas, onde a ativação de um neurônio dependia da soma ponderada das entradas recebidas.
Em 1958, Frank Rosenblatt desenvolveu o Perceptron, um modelo algorítmico, para o reconhecimento de padrões baseado em uma rede neural de camada única. Apesar das limitações iniciais demonstradas por Marvin Minsky e Seymour Papert em 1969, como a incapacidade de resolver problemas não linearmente separáveis, as décadas seguintes trouxeram avanços significativos.
A popularização das redes neurais ressurgiu nos anos 1980 com a introdução do algoritmo de retropropagação (backpropagation) por Rumelhart, Hinton e Williams, possibilitando o treinamento eficiente de redes multicamadas. Este algoritmo permanece como a quilha que sustenta o navio do treinamento usado nas redes neurais modernas, incluindo as utilizadas em algoritmos de word embeddings como o CBoW e o SkipGram.
O Neurônio Artificial
O elemento básico de uma rede neural artificial é o neurônio artificial, também chamado de unidade, vértice ou nó. Inspirado no neurônio biológico, ele recebe múltiplas entradas, processa-as e produz uma saída. A Figura 1 ilustra esta estrutura fundamental.
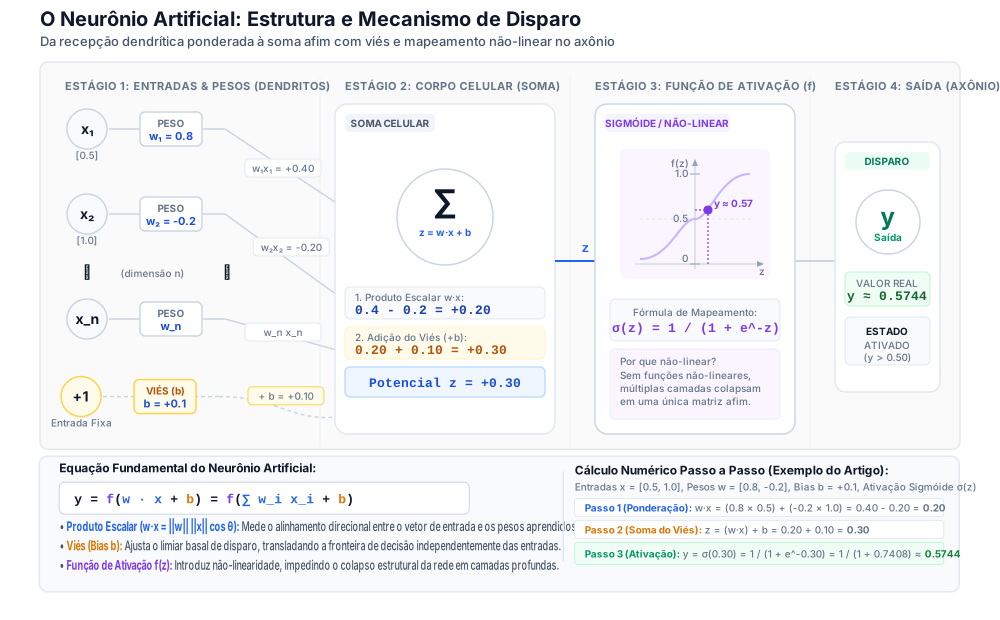
Figura 1: Representação de um neurônio artificial, mostrando entradas
Para dominar as redes neurais, precisamos entender a unidade mais básica a paciente leitora pode se divertir com o simulador de neurônio, a seguir, alterando os pesos e o viés (bias) para ver exatamente em que ponto o neurônio dispara.
Matematicamente, o neurônio artificial pode ser descrito por:
Nesta equação, temos:
-
são as entradas do neurônio; -
são os pesos associados a cada entrada; -
é o viés (bias), um termo que permite ajustar o limiar de ativação; -
é a função de ativação, que determina se, e como, o neurônio dispara com base na soma ponderada das entradas, , e do viés, . Essa função acrescenta a não-linearidades ao modelo, permitindo que ele aprenda padrões mais complexos. -
é a saída do neurônio.
A soma ponderada
Este artigo completo contém estratégias práticas e dados exclusivos reservados para nossos membros cadastrados.
Continuar com Google Acesso gratuito e instantâneo com sua conta Google(Updated: )