SimCLR: Aprender por Contraste e Pagar pelos Negativos
por Frank de Alcantara em 28/07/2026
- 1. Representações e Modelos de Mundo: o Mapa da Série
- 2. Autoencoders: o Gargalo, a Reconstrução e o Latente
- 4. Difusão Latente: Comprimir Antes de Gerar
- 5. SimCLR: Aprender por Contraste e Pagar pelos Negativos
- 6. BYOL: Aprender sem Negativos sem Entregar Tudo ao Colapso
- 7. DINO: Autodestilação e Objetos que Emergem da Atenção
- 8. MAE: Mascarar 75% da Imagem e Reconstruir o que Falta
- 9. Prever, não gerar: o template JEPA e o problema do colapso
Vamos mostrar à rede duas fotografias do mesmo cão: uma recortada, outra desfocada e com as cores alteradas. Depois vamos mostrar a fotografia de outro cão. Se a representação aproximar as duas primeiras e afastar a terceira, talvez tenha aprendido algo sobre identidade visual. Talvez tenha aprendido apenas nossa escolha de recortes e cores. O SimCLR é interessante justamente porque transforma essa ambiguidade em uma tarefa precisa.
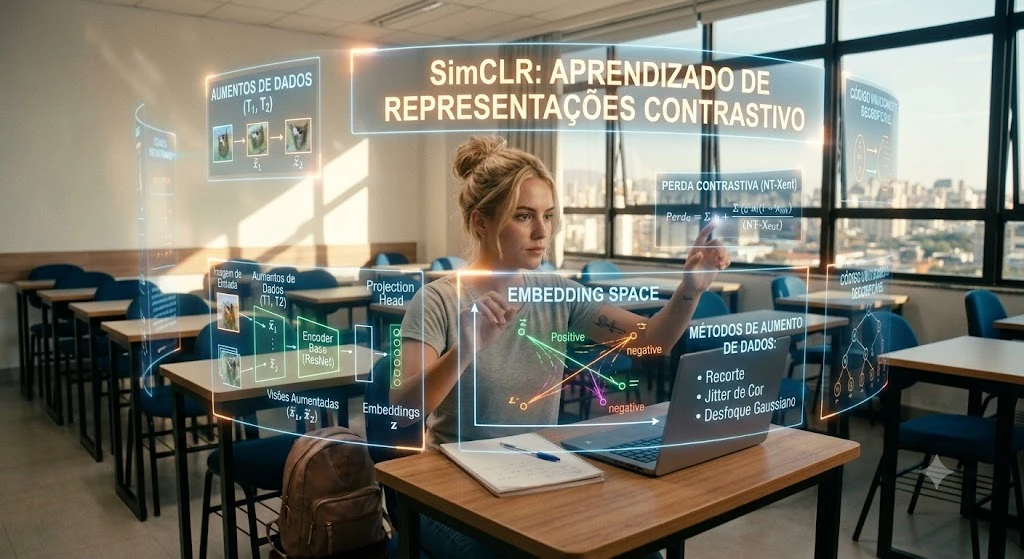
O autoencoder organiza um latente para reconstrução. A difusão latente organiza um espaço para geração. O SimCLR abandona ambos os contratos. Em vez de perguntar “consigo refazer a entrada?”, pergunta “duas transformações da mesma imagem chegam ao mesmo lugar, e imagens diferentes permanecem separadas?”. Não há decoder de pixels. Há geometria, temperatura e um lote cheio de adversários involuntários.
1. Duas views definem o positivo
Para cada imagem
Essas duas views formam um par positivo. As views de outras imagens no lote funcionam como negativos. Com
O encoder
Este artigo completo contém estratégias práticas e dados exclusivos reservados para nossos membros cadastrados.
Continuar com Google Acesso gratuito e instantâneo com sua conta Google(Updated: )