BYOL: Aprender sem Negativos sem Entregar Tudo ao Colapso
por Frank de Alcantara em 28/07/2026
- 1. Representações e Modelos de Mundo: o Mapa da Série
- 2. Autoencoders: o Gargalo, a Reconstrução e o Latente
- 4. Difusão Latente: Comprimir Antes de Gerar
- 5. SimCLR: Aprender por Contraste e Pagar pelos Negativos
- 6. BYOL: Aprender sem Negativos sem Entregar Tudo ao Colapso
- 7. DINO: Autodestilação e Objetos que Emergem da Atenção
- 8. MAE: Mascarar 75% da Imagem e Reconstruir o que Falta
- 9. Prever, não gerar: o template JEPA e o problema do colapso
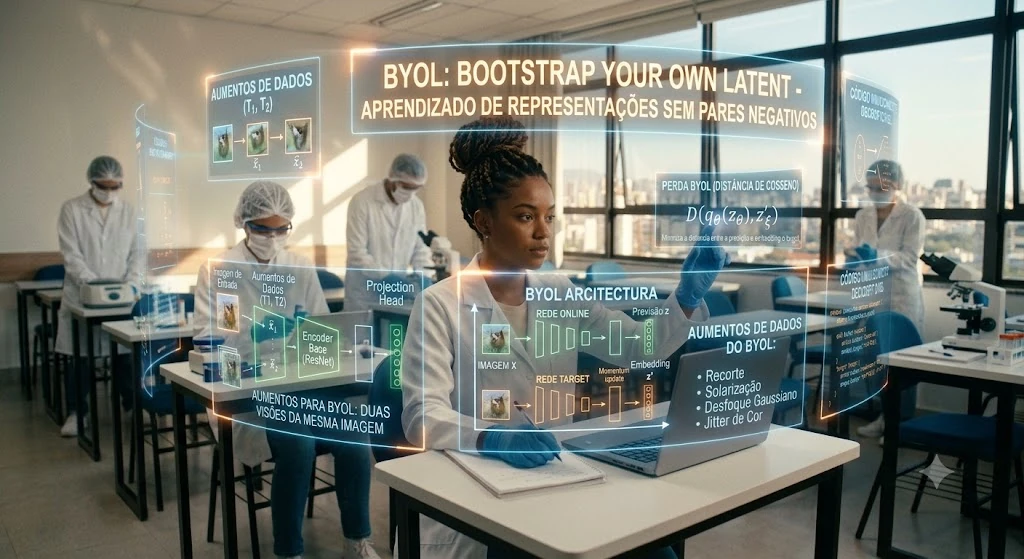
No SimCLR, cada imagem encontra uma companheira positiva e uma multidão de negativas. Vamos retirar a multidão. Se pedirmos apenas que duas views da mesma imagem produzam a mesma representação, a rede pode resolver o problema atribuindo o mesmo vetor a tudo. Cães, pontes e torradeiras finalmente unidos, embora por uma geometria inútil.
O BYOL, de Bootstrap Your Own Latent (algo como construir a própria representação por autoalimentação), aceita o risco e remove todos os pares negativos. Duas views da mesma imagem devem concordar, mas nenhuma imagem diferente entra no denominador. O método funciona apesar da solução constante, apoiado em uma arquitetura assimétrica e em uma dinâmica em duas escalas. A distinção importa: observamos resistência ao colapso; não recebemos uma prova universal de que a função constante seja impossível.
1. Duas redes, três cabeçalhos
Uma view
O encoder
Este artigo completo contém estratégias práticas e dados exclusivos reservados para nossos membros cadastrados.
Continuar com Google Acesso gratuito e instantâneo com sua conta Google(Updated: )